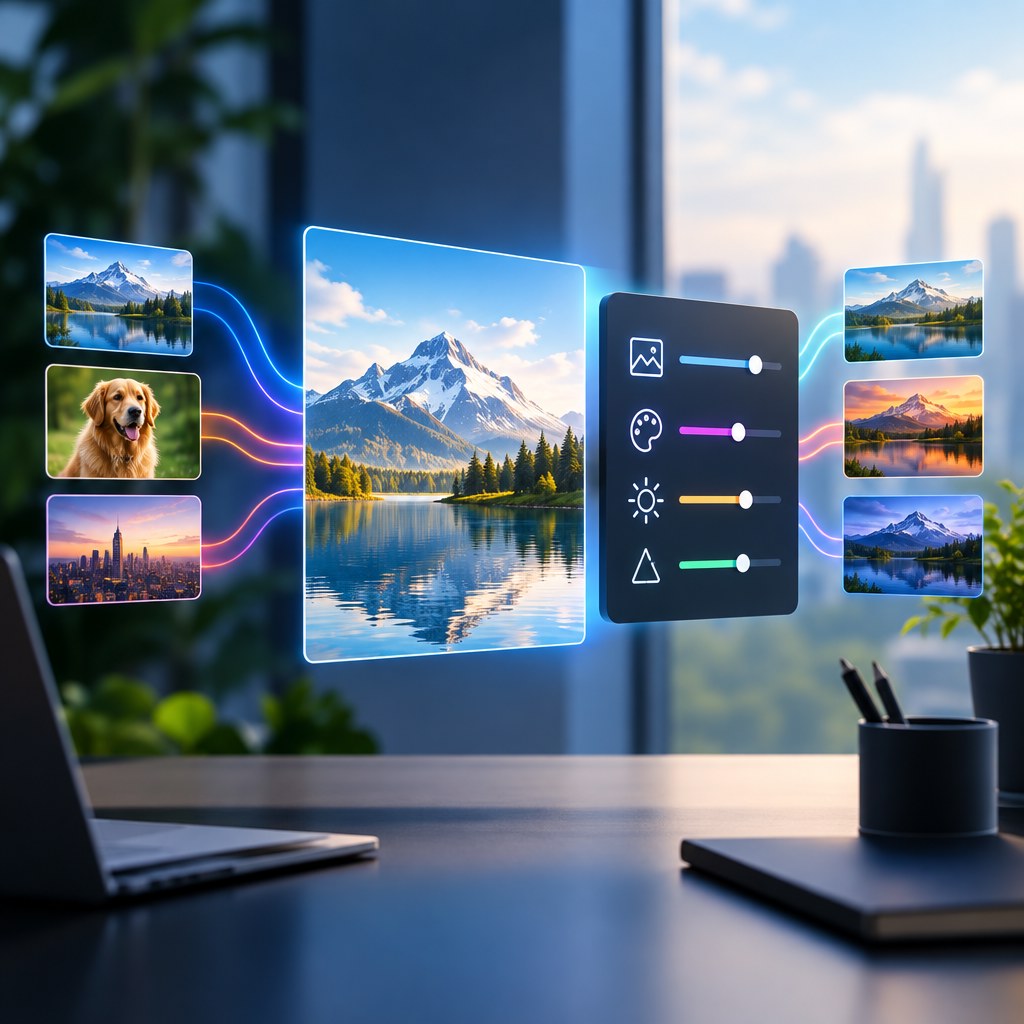
در دنیای پرشتاب و در حال تکامل هوش مصنوعی، مدلهای تولید تصویر (Generative AI) به سطح بیسابقهای از واقعگرایی و کیفیت دست یافتهاند. با این حال، یکی از بزرگترین چالشهایی که توسعهدهندگان، طراحان گرافیک و هنرمندان دیجیتال با آن روبهرو هستند، مسئله «کنترل دقیق» بر روی خروجی نهایی است. در بسیاری از مواقع، شما یک پرامپت (دستور متنی) بسیار دقیق و طولانی مینویسید، اما هوش مصنوعی جزئیات را با هم ترکیب میکند؛ مثلاً رنگ لباس یک شخصیت را به ماشین پسزمینه انتقال میدهد یا در درک موقعیت مکانی اشیا دچار اشتباه میشود. برای حل این مشکل بنیادین، بخش تحقیقات گوگل (Google Research) در تاریخ ۲۹ سپتامبر ۲۰۲۶، از یک دستاورد علمی و معماری نوین به نام Diffusion Controller پردهبرداری کرد.
این تکنولوژی جدید که در وبلاگ رسمی تحقیقات گوگل با جزئیات فنی منتشر شده است، وعده میدهد که با یکپارچهسازی و سادهسازی فرایند تولید تصویر، کنترل بسیار بالاتری را بدون نیاز به آموزشهای مجدد سنگین فراهم کند. اما پیش از هر چیز، باید یک نکته بسیار مهم را روشن کنیم: این فناوری در حال حاضر صرفاً یک پژوهش علمی و اثبات مفهوم (Proof of Concept) است. Diffusion Controller یک قابلیت عمومی یا ابزاری تجاری در چتبات Gemini یا سایر سرویسهای ابری گوگل نیست و نباید انتظار داشته باشید که همین امروز بتوانید از آن در حساب کاربری استاندارد خود استفاده کنید. هدف از این پژوهش، هموار کردن مسیر برای نسل بعدی مدلهای دیفیوژن است.
چرا مدلهای دیفیوژن به کنترلر نیاز دارند؟
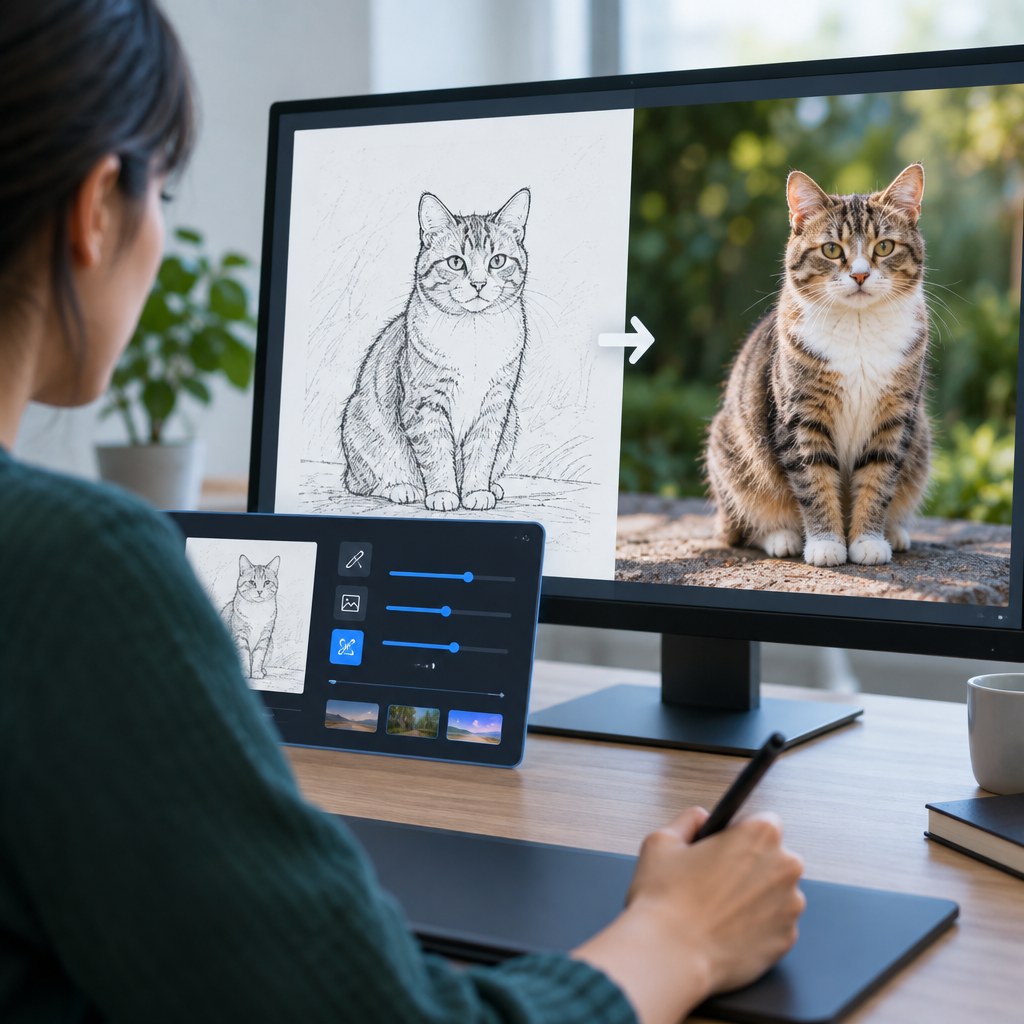
مدلهای دیفیوژن استاندارد، تصاویر را از طریق فرایندی به نام «نویززدایی تدریجی» تولید میکنند. آنها یک بوم پر از نویز تصادفی را میگیرند و قدم به قدم، با توجه به راهنماییهای متنی شما، نویزها را حذف کرده و به تصویر نهایی میرسند. مشکل اصلی اینجاست که درک فضایی (Spatial Understanding) مدلها در ذات خود محدود است. پدیدهای به نام نشت ویژگیها (Attribute Leakage) بسیار شایع است؛ به این معنا که ویژگیهای یک شیء در تصویر، به شیء دیگری سرایت میکند.
تا پیش از معرفی Diffusion Controller گوگل، راهکارهای موجود مانند ControlNet یا T2I-Adapter نیازمند آموزش دادن شبکههای عصبی جداگانه و اضافهکردن لایههای سنگین به مدل اصلی بودند. این کار نه تنها هزینههای محاسباتی را به شدت افزایش میداد، بلکه یکپارچگی سیستم را نیز مختل میکرد. پژوهش جدید گوگل با هدف حذف این موانع شکل گرفته است تا بتواند با دخالت مستقیم در نقشههای توجه (Attention Maps)، تصویر نهایی را در همان مرحله تولید، بدون نیاز به شبکههای کمکی عظیم، هدایت کند.
نکته کلیدی: برخلاف افزونههای سنگین گذشته، Diffusion Controller مستقیماً با تنظیم پارامترهای داخلی مدل پایه کار میکند و همین موضوع باعث کاهش چشمگیر پیچیدگیهای پردازشی میشود.
تفاوت رویکردهای White-box و Gray-box در پژوهش گوگل
یکی از جذابترین بخشهای مقاله منتشر شده در ۲۹ سپتامبر ۲۰۲۶، معرفی دو رویکرد متفاوت برای اعمال این کنترلر است. تیم تحقیقاتی گوگل بهخوبی میداند که همه مدلهای هوش مصنوعی بهصورت متنباز (Open Source) در دسترس نیستند، بنابراین راهکار خود را در دو سطح مجزا ارائه کرده است:
۱. رویکرد جعبه سفید (White-box)
در سناریوی White-box، فرض بر این است که مهندسان هوش مصنوعی به تمامی کدهای منبع، وزنها (Weights) و معماری داخلی مدل دیفیوژن دسترسی کامل دارند. در این حالت، Diffusion Controller میتواند مستقیماً وارد لایههای Cross-Attention (که ارتباط بین متن و تصویر را مدیریت میکنند) و Self-Attention (که انسجام داخلی تصویر را حفظ میکنند) شود. با این دسترسی کامل، کنترلر میتواند در هر مرحله از نویززدایی، بهطور دقیق مشخص کند که هر پیکسل باید به کدام بخش از پرامپت توجه کند. این حالت امکان میدهد کنترلر و مدل پایه با دسترسی کاملتری به پارامترها بهینه شوند.
۲. رویکرد جعبه خاکستری (Gray-box)
از سوی دیگر، رویکرد Gray-box برای زمانهایی طراحی شده است که مدل هوش مصنوعی مانند یک سرویس API عمل میکند و دسترسی کامل به وزنهای داخلی آن وجود ندارد. در این معماری، مدل پایه بهعنوان یک «جعبه سیاه» عمل میکند، اما واسطهایی برای تنظیم ورودیهای نهان (Latents) در اختیار کاربر قرار میدهد. Diffusion Controller در حالت جعبه خاکستری، از تکنیکهای بهینهسازی گرادیان بر روی ورودیهای میانی استفاده میکند تا بدون تغییر دادن کدهای اصلی مدل، خروجی را به سمت خواستههای کاربر سوق دهد. این رویکرد برای سناریوهایی اهمیت دارد که دسترسی به لایهها و وزنهای مدل محدود است.
نتایج پژوهش و عملکرد در ارزیابیها
هنگام بررسی مقالات علمی در حوزه هوش مصنوعی، اعداد و ارقام حرف اول را میزنند. تیم پژوهش گوگل در مقاله خود نتایج بسیار قابل توجهی را گزارش کرده است، اما تأکید میکند که این نتایج در محیطهای آزمایشگاهی و بر روی دیتاستهای خاص به دست آمدهاند. بر اساس ارزیابیهای انجام شده، Diffusion Controller توانسته است در مقایسههای مرتبط با کنترل فضایی و پایبندی به پرامپتهای پیچیده، در نسخه کاملاً باز یا White-box، نرخ برد ۹۰ درصدی در مقایسه با مدل پایه گزارش شده است. این عدد مربوط به همان مقایسه آزمایشی است و نباید آن را به همه مدلها یا همه سناریوهای تولید تصویر تعمیم داد.
همچنین در این تحقیق از معیار معتبر HPS-v2 (Human Preference Score v2) استفاده شده است. معیار HPS-v2 یک مدل ارزیابی است که ترجیحات بصری انسانها را شبیهسازی میکند. در مسیرهای SFT و RWL، نسخه Gray-box در نرخ برد HPS-v2 از LoRA بهتر عمل کرد. همچنین گوگل گزارش کرده است که ارزیابی انسانی در پرامپتهای پیچیده و چندویژگی، کیفیت ذهنی و تطابق با پرامپت را به نفع Diffusion Controller نشان داده است.
ویژگیهای کلیدی معماری جدید گوگل
برای درک بهتر ارزش این تحقیق علمی، مهم است بدانیم چه نوآوریهایی این کنترلر را از نسلهای قبلی متمایز میکند. در ادامه به مهمترین ویژگیهای ساختاری آن میپردازیم:
⚙️
عدم نیاز به آموزش مجدد
این کنترلر در حین اجرای تولید تصویر (Inference) عمل میکند و نیازی به پردازشهای سنگین برای آموزش مجدد وزنهای شبکه ندارد.
🎯
دقت فضایی بالا
هدف چارچوب، افزایش تطابق خروجی با ترجیحات و محدودیتهای تعیینشده برای تولید تصویر است.
📊
انعطاف در پیادهسازی
چارچوب برای محیطهای White-box و Gray-box بررسی شده و گوگل کاربرد آن را برای مدلهای دارای دسترسی محدود نیز مطرح کرده است.
مقایسه فنی با روشهای سنتی
برای درک بهتر جایگاه این پژوهش، جدول زیر مقایسهای سریع بین Diffusion Controller و روشهای رایج فعلی ارائه میدهد:
| ویژگی مورد بررسی | Diffusion Controller (پژوهش گوگل) | افزونههای سنتی (مثل ControlNet) |
|---|---|---|
| نیاز به آموزش (Training) | ندارد (Training-Free) | نیاز به آموزش شبکههای کمکی سنگین |
| انعطافپذیری معماری | بالا (پشتیبانی از White-box و Gray-box) | محدود (نیازمند دسترسی کامل به لایهها) |
| نوع دسترسی به مدل | قابل استفاده در حالت Gray-box و White-box | بسته به روش، معمولاً نیازمند دسترسی و آموزش آداپتر |
نتیجهگیری
پژوهش گوگل در سپتامبر ۲۰۲۶ نشان میدهد که کنترل مدلهای تولید تصویر را میتوان بهصورت یک مسئله یکپارچهتر و قابلبهینهسازی صورتبندی کرد. Diffusion Controller در آزمایشهای گزارششده، هم در محیطهای White-box و هم Gray-box نتایج امیدوارکنندهای داشته است؛ از جمله نرخ برد ۹۰ درصدی نسخه کاملاً باز در برابر مدل پایه. اگرچه این تکنولوژی هنوز راه خود را به ابزارهای عمومی مانند Gemini باز نکرده و صرفاً یک دستاورد پژوهشی است، اما میتواند مسیر پژوهش برای کنترل بهتر مدلهای تولید تصویر و در آینده حتی مدلهای ویدیویی را گسترش دهد.
آمادهاید تا با جدیدترینهای هوش مصنوعی همراه شوید؟
اگر به تکنولوژیهای نوین تصویرسازی علاقهمند هستید و میخواهید از جدیدترین اخبار و ترفندهای هوش مصنوعی مطلع بمانید، مقالات تخصصی فوتو فان را دنبال کنید.
